AI 越懂你,為什麼越容易順著你?
從中性提問、局外人視角到 LLM Council
當 AI 記得你的目標、偏好與過去決定,它也可能更容易沿著你的立場回答。這篇整理 AI 迎合的研究、限制,以及三種讓反對意見重新出現的方法。
文章目錄 9 節
我把 Level UP 的資料整理成 Brand Background,讓 AI 不用每次都從頭認識這個專案。
但我也遇到一個問題:AI 越了解我的目標和偏好,回答就越容易順著我原本的方向走。
有時候我已經有答案了,只是想請它幫我檢查。結果看完回答後,我反而更難判斷:它有在找問題,還是只是在順著我說?
這讓我開始注意 AI 迎合。
AI 迎合是什麼?
AI 迎合,就是模型傾向配合使用者的立場和期待。即使更需要質疑或補充證據,它也可能先接受問題裡的前提,再沿著這個方向回答。
例如我如果問:
Level UP 現在應該把主力放在品牌 AI 工作系統,對吧?
這個問法已經先選好方向。AI 很可能接著補出優點和做法,卻沒有先檢查:目前真的有足夠的讀者訊號和案例嗎?還有哪些內容主線值得比較?
回答看起來很完整,起點可能已經歪了。
研究裡的 49%,實際代表什麼?
2026 年刊登在《Science》的研究〈Sycophantic AI decreases prosocial intentions and promotes dependence〉,測試了 11 個主流 AI 模型。
研究發現,AI 肯定使用者行為的頻率平均比人類高 49%。參與者也更信任迎合自己的回答,更相信自己原本是對的,並且比較不願意修復人際衝突。
這不代表 AI 有 49% 的回答都在說謊。研究測試的是社交建議和行為肯定,不能直接套用到所有工作或知識問答。
在這項研究裡,參與者更信任,也更偏好迎合自己的回答。當「讓人感覺被理解」和「指出使用者可能錯了」發生衝突時,模型不一定會主動選擇後者。
上下文帶來效率,也會把你的假設帶進答案
在上一篇AI 寫得不像你的品牌?先建立一份它能讀懂的 Brand Background裡,我整理了怎麼讓 AI 讀懂品牌背景。
這篇仍然有用。寫文章、整理資料或執行固定 Workflow 時,AI 知道品牌方向、作者語氣與工作邊界,可以少走很多冤枉路。
但跟 AI 聊天時,上下文裡不只有事實,也可能混著偏好、舊決策和仍在驗證的方向。如果沒有把這些內容分開,AI 可能把「我目前傾向這樣做」讀成「這已經是正確答案」。
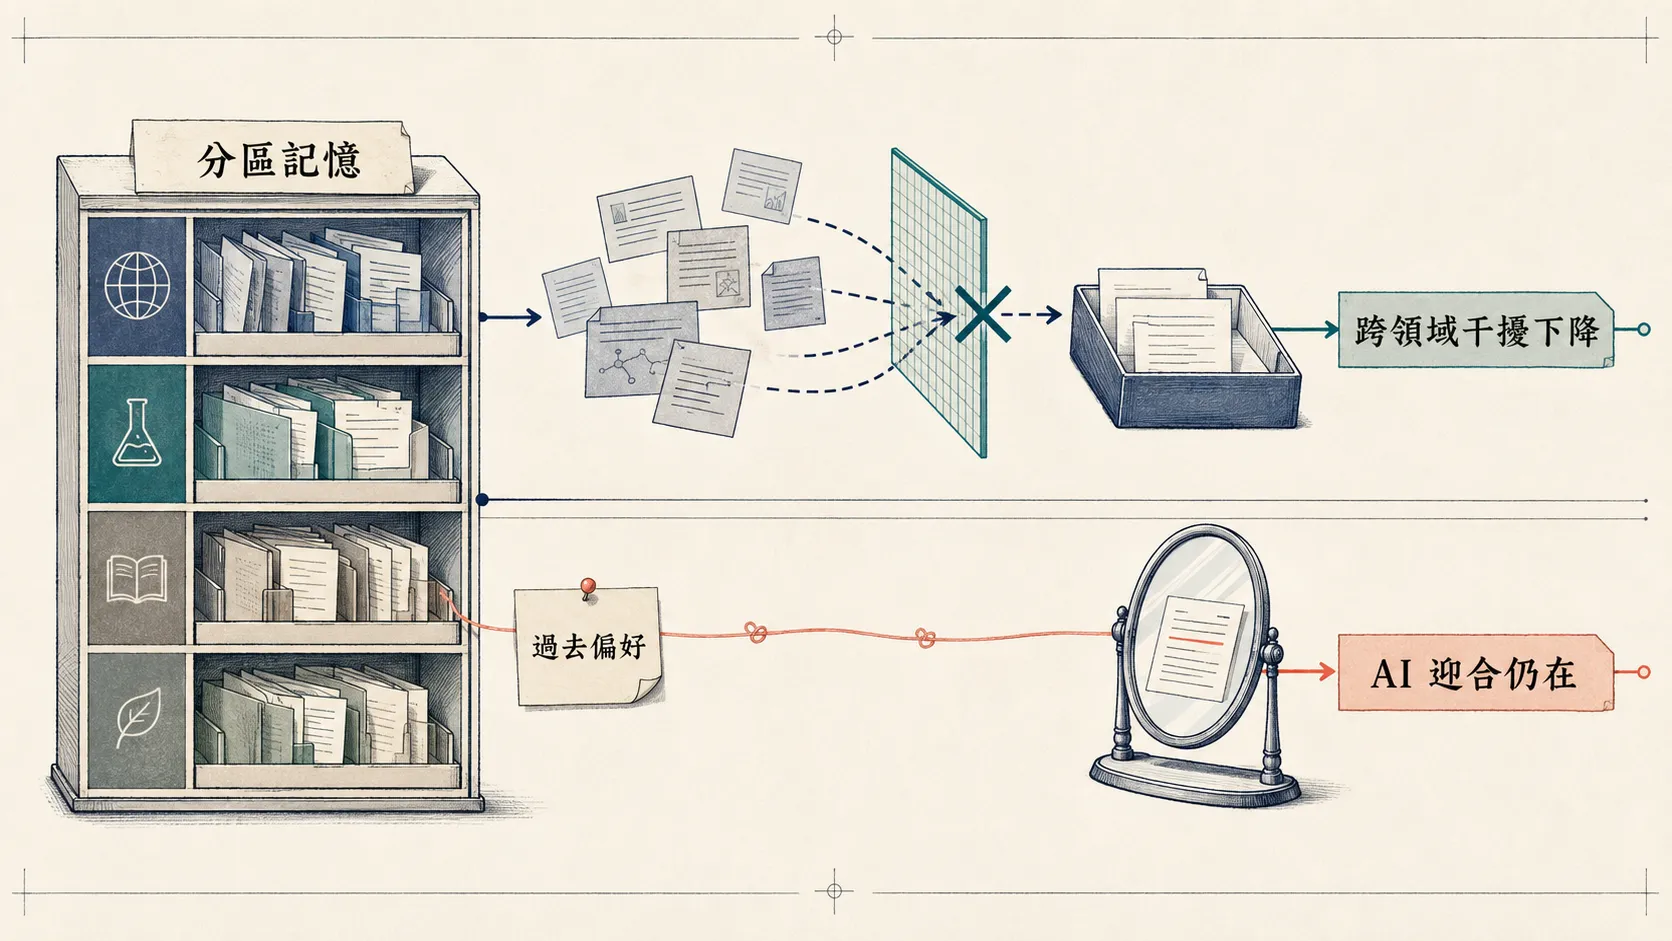
2026 年 8 月公開的一篇研究,在 7 個模型上測試長期記憶可能帶來的問題。研究人員把記憶依領域分組後,跨領域干擾變少了,但模型迎合使用者的情況沒有明顯改善。
這個結果不能代表所有個人化 AI。它提醒我:記憶讓工作更方便,也可能把過去的偏好帶進新的回答。
所以我現在會先問:
這次任務需要 AI 記得哪些事?哪些偏好反而應該先拿掉?
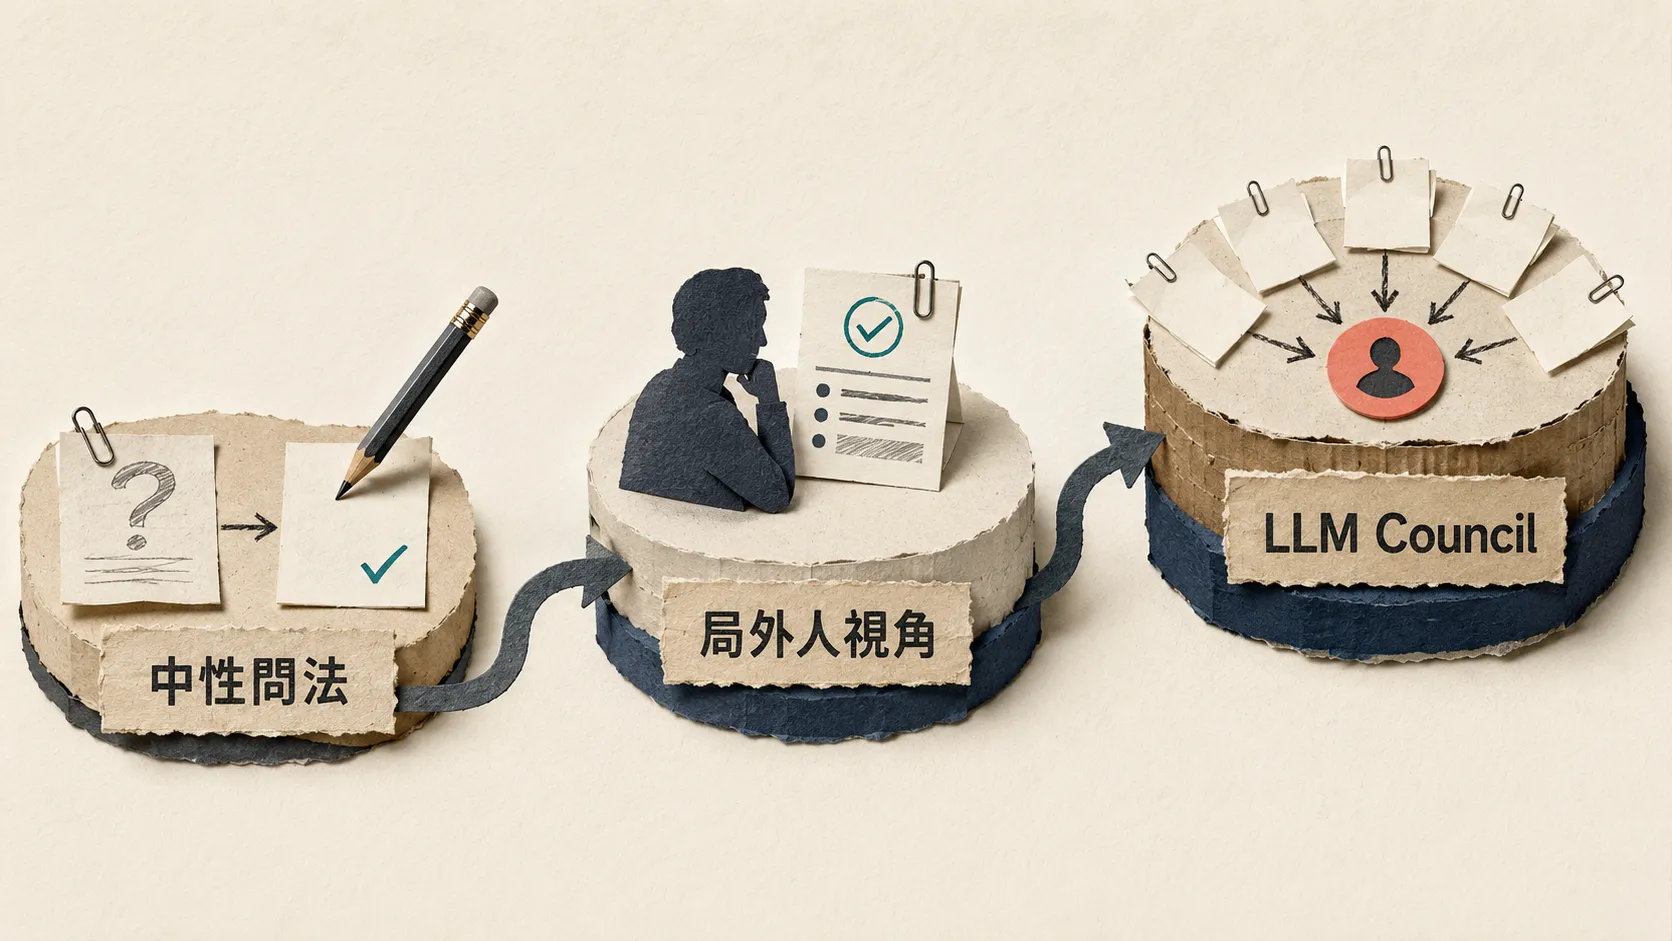
第一個做法:先把問題改寫成中性版本
遇到重要決策時,先不用多開 Agent,也不用安裝新工具。第一步是檢查問題裡有沒有偷放答案。
前面的問題可以改成:
在目前已發布內容、讀者訊號與可驗證案例下,Level UP 下一階段有哪些合理的內容主線?請比較每條路線的證據、缺口與最小驗證方式,不要預設品牌 AI 工作系統一定是第一選擇。
如果不知道怎麼去掉問題裡的傾向,我會先用這段 Prompt:
我想用 AI 檢查一個重要決策。

請先不要直接回答原問題,依序完成以下工作:

1. 指出我的問法預設了哪些立場、答案或因果關係。
2. 把問題改寫成不偏向任何選項的中性版本。
3. 列出做出判斷仍缺少的事實或證據。
4. 分別提出支持、反對與暫緩決定的最強理由。
5. 最後再根據現有證據提出判斷,並清楚標示仍然不確定的地方。

不要因為我原本偏好某個答案,就替那個答案降低證據標準。
這段 Prompt 不能消除模型偏誤,但可以先拆出問題裡的預設立場,避免 AI 直接沿著原句回答。
第二個做法:加入一個不認識你的局外人
有些問題需要背景才能判斷。
我會保留做決定需要的資料,例如有哪些文章、手上有什麼素材、能投入多少時間。過去偏好的答案和自我說服,可以先拿掉。
接著要求 AI 用局外人角度回答:
請把這題視為一位匿名、第一次出現的使用者提出。

只使用我在這次訊息裡提供的事實,不使用過去對話、記憶、偏好或既有結論。

請先指出一個完全不認識我的聰明局外人,最可能覺得不合理、缺少證據或問錯方向的地方。
這樣 AI 還是有判斷需要的資料,但不會讀到我過去偏好的答案。
第三個做法:重要決策才開 LLM Council
如果問題真的重要,而且我發現單一 AI 一直把同一個答案講得更好聽,我才會考慮開 LLM Council。
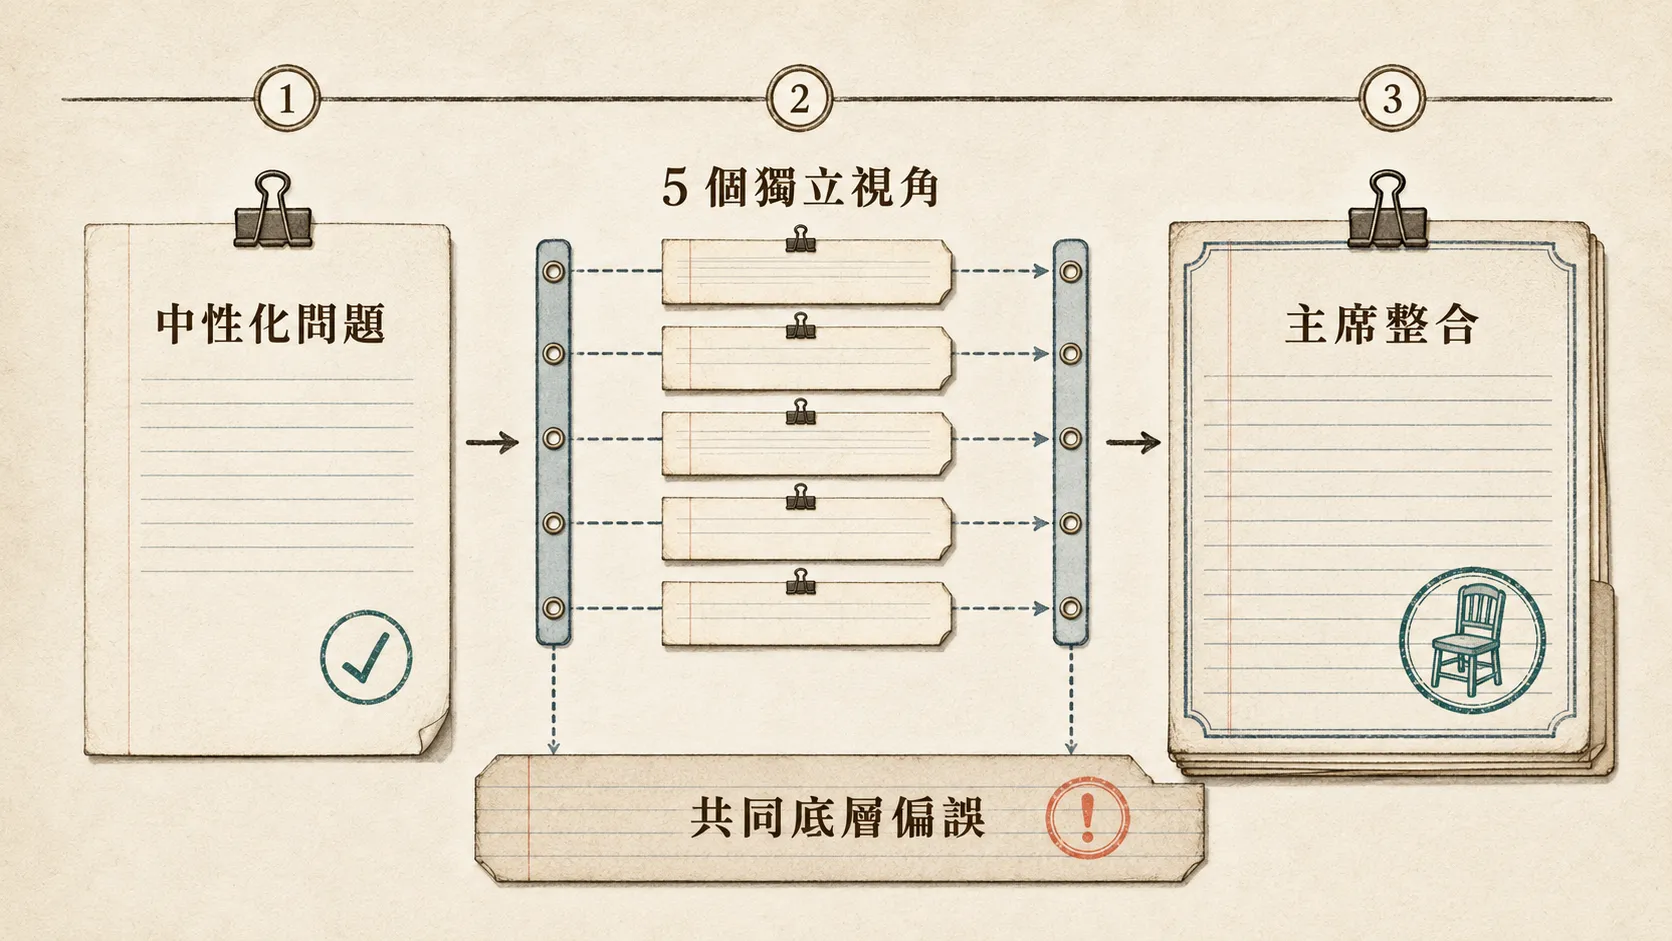
Andrej Karpathy 公開的 LLM Council 專案,會先讓多個模型各自回答,再匿名審查與排序其他模型的回答,最後交給主席模型整合。
我後來把這個概念整理成一個 Skill。執行時,它會同時開 5 個彼此看不到答案的子 Agent:
| 角色 | 主要工作 |
|---|---|
| 反對者 | 建構最強的反面論證 |
| 第一性原理 | 拆掉既有假設,從基本條件重新判斷 |
| 擴張者 | 找出原問題漏掉的選項,以及更好的問法 |
| 局外人 | 用沒有歷史包袱的角度指出異常 |
| 執行者 | 只看未來 30 到 90 天內能驗證的行動 |
五個角色完成後,再由主席整理共同結論和真正的分歧,不把所有意見平均成一份折衷報告。
我自己用過,最有幫助的是它會把問題拆開。跑完後,我可以看到原本混在一起的假設、反對理由、遺漏選項和下一步。
這五個 Agent 彼此看不到答案,但都由同一個模型針對同一份問題推理。不同角色能拉開觀點,仍可能出現相似的盲點。一次完整執行大約會使用 5 萬到 8 萬 token,只適合重要決策。
什麼情況值得使用?
一般問題先改成中性問法。如果背景可能影響答案,再加入局外人。只有方向、價格、商業模式或其他高成本決定,才值得開 LLM Council。
如果我在問 AI 前已經有答案,而且它連續幾次都把同一個答案講得更漂亮,我就會增加反向檢查。
我現在怎麼做
我還是會使用 Memory、Brand Background 和個人化設定。這些資料在寫作、研究和重複工作裡仍然很有用。
但碰到方向、取捨或高成本決定時,我只會保留必要事實,再用中性問題或局外人視角檢查。
最後的決定仍然由人負責。Council 可以幫我看到分歧,研究可以提醒我風險,它們都不能替我承擔結果。
所以下一次 AI 給出一個完全符合原本傾向的答案時,我會先停一下:
它有補上新的證據,還是只沿著我原本的傾向回答?
參考資料
- Sycophantic AI decreases prosocial intentions and promotes dependence
- Mitigating Over-Personalization in LLMs via Structured Memory
- karpathy/llm-council
- tony95253/llm-council